面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP’26
AI新闻阅读 0
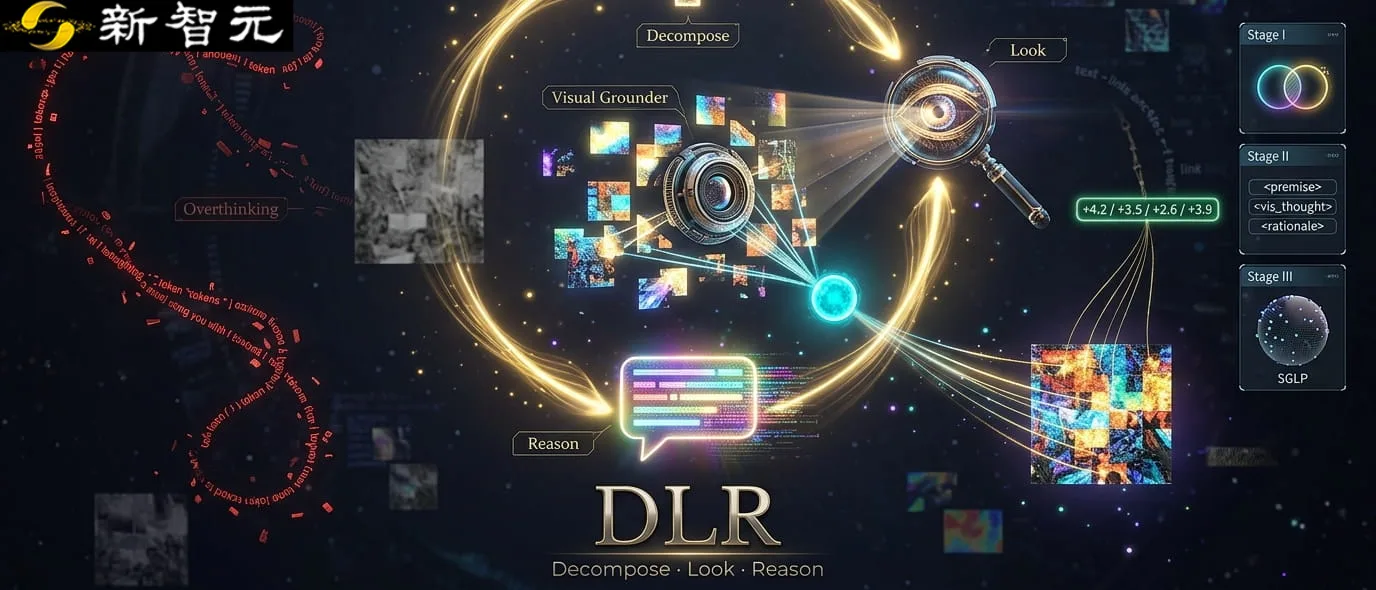
美国埃默里大学研究团队提出Decompose–Look–Reason(DLR)框架,用于解决多模态推理中视觉证据弱化问题。该方法被EMNLP 2026 Main Conference接收,旨在通过动态拆解问题、提取视觉证据并进行推理,提升视觉语言模型的推理能力。
现有方法存在信息损失或工具调用成本高的问题。DLR通过显式耦合视觉验证问题与图像证据提取,使视觉证据成为推理轨迹中可动态更新的条件。其核心流程包括拆解问题生成文本前提、提取对应视觉隐空间表示,并基于视觉证据生成推理依据。
论文指出局部ROI无法覆盖跨区域关系或抽象视觉概念,因此设计三阶段训练流程。第一阶段预训练视觉 grounder,第二阶段监督微调学习结构化推理轨迹,第三阶段通过强化学习优化连续视觉隐空间表示。
实验基于Qwen3-VL-8B-Thinking模型,在V* Bench、MathVista等四个基准测试中,DLR分别达到83.8、82.7等成绩,较基线模型提升3.5-4.2个百分点。消融实验显示,强化学习优化连续隐空间对性能提升具有关键作用。
案例分析表明,DLR能有效解决视觉 grounding 不足导致的过思考问题。在图形规律推理任务中,DLR通过分步提取视觉证据,避免了基线模型因局部特征干扰导致的错误判断。