港科大发布AccelEval基准:AI能否真正实现CPU到GPU全流程加速?
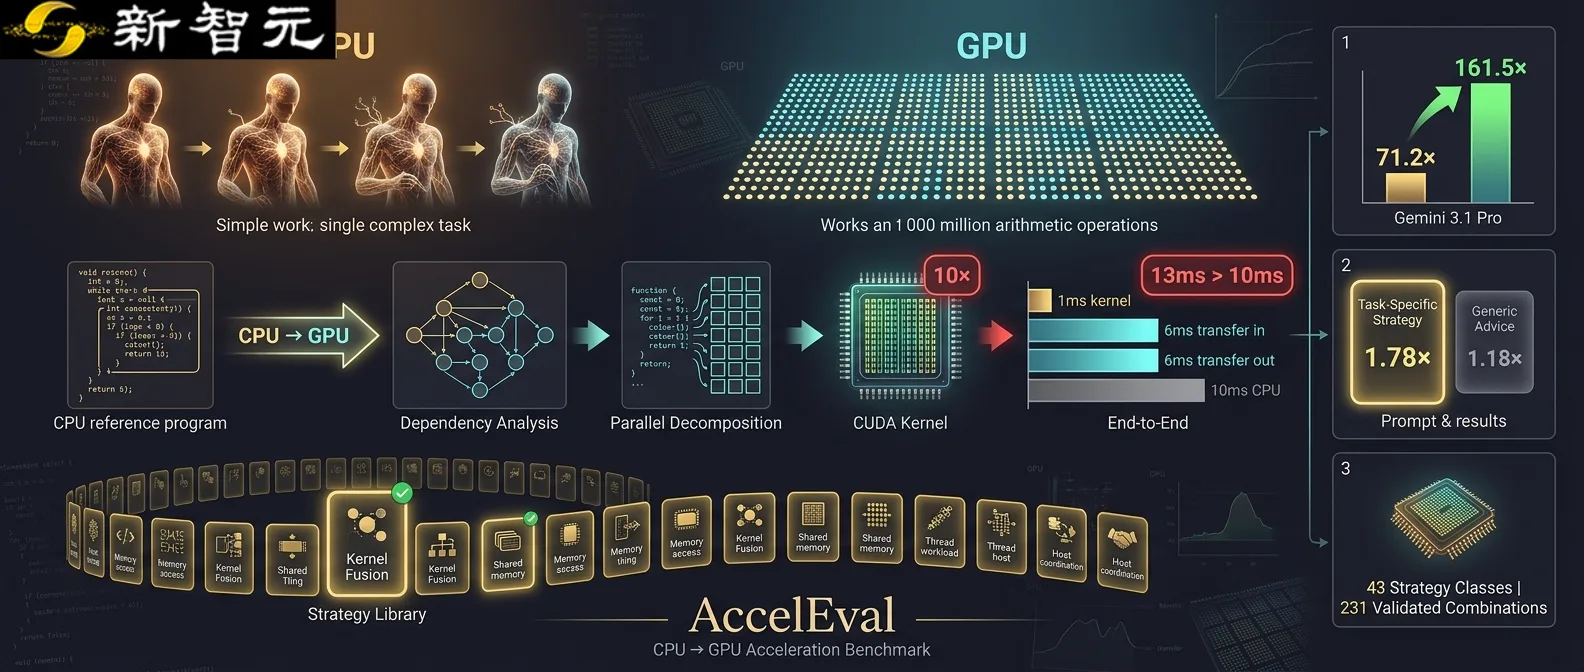
在科学仿真、金融计算、图算法和运筹优化等领域,程序正确性已获保障却面临运行效率瓶颈。港科大团队提出AccelEval基准测试,通过可信CPU程序验证AI生成的GPU实现是否在结果正确性与端到端速度上实现突破。该基准覆盖高性能计算、科学仿真、图算法等6大领域共42项任务,系统整理43类CUDA优化策略,被NeurIPS 2026收录。
AccelEval评测框架要求AI不仅完成代码翻译,还需理解计算依赖关系,设计并行化分工方案。以最短路径计算为例,AI需识别可并行计算的候选结果,同时处理跨阶段依赖关系,并优化数据在GPU与主机间的存储位置。研究指出,单纯提升核心计算速度可能因数据搬运开销导致整体效率下降。
当前主流基准如KernelBench侧重深度学习算子的GPU实现,但AccelEval聚焦更复杂场景:用户往往仅提供正确但低效的CPU程序,包含多层循环、条件分支等结构。这类任务需要AI理解完整计算结构,确定并行化方案,而非简单套用现有模板。
评测包含小中大三种输入规模,要求模型提交的GPU版本需通过编译验证,并在相同输入下与CPU输出比对。数值敏感任务设置误差容限,确保正确性前提下评估性能提升。论文在NVIDIA H200平台测试8个大模型,Gemini 3.1 Pro在中规模任务中实现71.2倍几何平均加速比,大规模任务达161.5倍。
研究强调正确性与性能的双重考核,不仅统计通过任务数,还分析方案与最佳实现的差距。人工参考实现作为参照,帮助评估AI生成代码的优化空间。AccelEval通过统一输入输出接口,将评测延伸至计算依赖分析与资源调度策略验证。
该基准测试覆盖路径计算、期权定价、库存补货等实际应用,揭示AI在跨领域计算结构优化中的能力边界。研究指出,仅依赖成熟算子模式难以应对复杂程序,需模型具备自主设计并行化方案的能力。论文链接:https://papers.ssrn.com/sol3/papers.cfm?abstract_id=6835659 代码链接:https://github.com/Echoscd/AccelEval
AccelEval通过端到端计时机制,将数据搬运、内存分配等开销纳入评测范围,避免隐藏工作量。研究团队设置审计机制,确保评测结果反映真实性能表现,而非局部代码优化效果。这项工作为AI驱动的高性能计算提供了更全面的评估标准。