墨尔本大学提出 VoxMem 基准,揭示音频大模型在长历史会话中记忆能力严重不足
AI新闻阅读 3
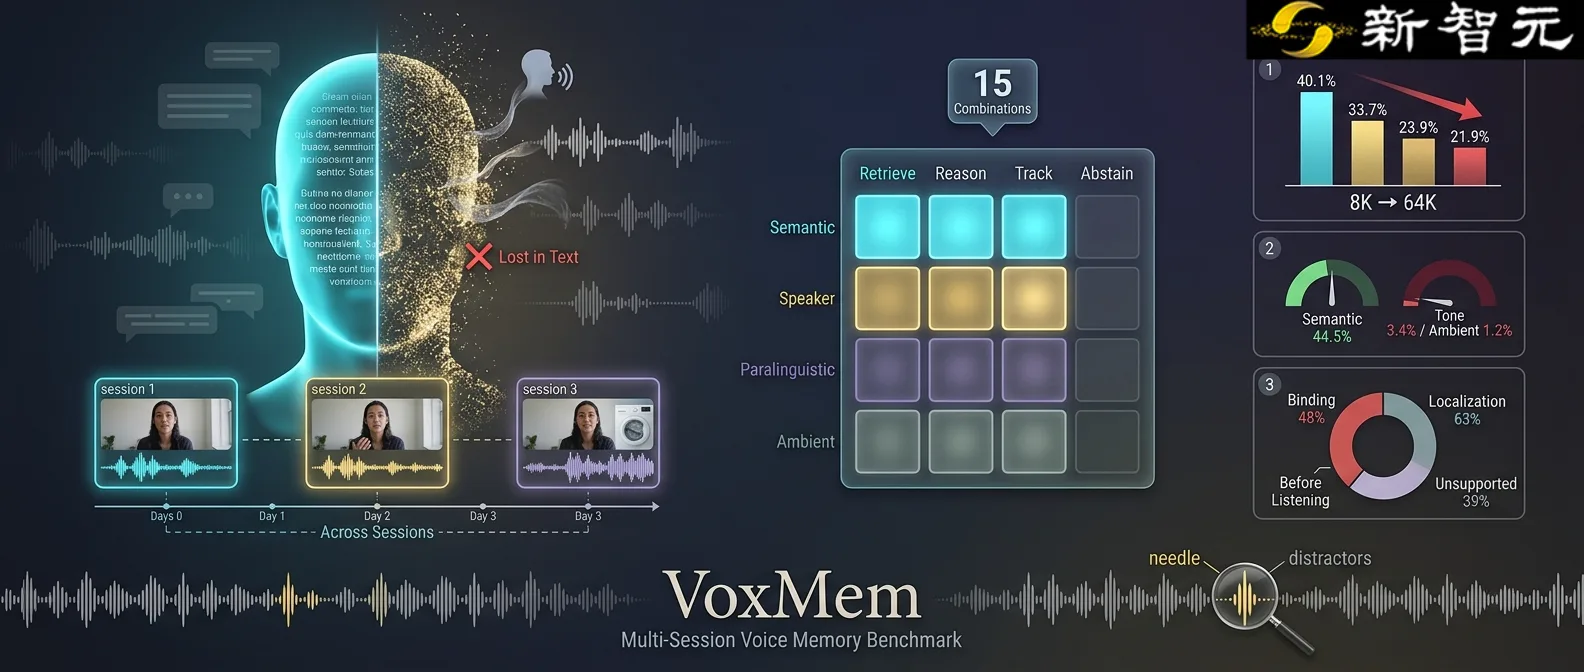
针对现有语音评测无法有效考察说话人身份、语气及背景声等声学信息的难题,墨尔本大学与新南威尔士大学联合团队推出了多会话语音记忆基准 VoxMem。该基准旨在解决真实交互中跨越多次会话的记忆追踪问题,并填补了传统方法仅依赖单段录音或忽视历史长度影响的空白。VoxMem 构建了基于「声学证据×记忆操作」的二维分类框架,覆盖了除纯文本检索外的 15 种考察组合。数据集包含约 177 小时的音频,由 34,743 个语音会话组成 3,196 个评测实例,涵盖身份识别、副语言线索及环境声等多种「音频原生」信息类型。在评测中,VoxMem 采用了严格的「同一句话录两个版本」及固定长度历史(8K 至 64K token)设计,确保分数下降仅归因于历史长度增加而非内容变难。实验结果表明,即便面对完美的文字转写,涉及非文本信息的题目准确率也骤降至 4.4%,证明这些考点必须依赖声音特征作答。对 15 个音频大模型(包括开源与闭源)的评测显示,在 32K token 历史长度下,没有任何模型的整体准确率超过 40%。其中排名第一的开源模型 Qwen3.8-Omni-Flash 仅为 38.5%,而闭源模型平均准确率为 33.0%,开源模型则为 21.9%。进一步细分发现,模型在语音语义信息上表现尚可,但在说话人身份、语气变化和背景声变化等声学线索上的识别能力极弱,平均准确率分别仅为 32.7%、20.0% 和 21%。这表明当前大模型在长期对话中仍难以保留关键的听觉记忆特征。VoxMem 项目提供了完整的代码库与论文链接(https://arxiv.org/abs/2609.32607 / https://github.com/swagshaw/voxmem),为音频大模型的长上下文理解与研究评估设立了新的行业标准,揭示了当前技术从「能听懂」到「真记住」之间的巨大鸿沟。