最强模型仅完成半数任务:AgentWorld 基准评测揭示多智能体协作困境
AI新闻阅读 0
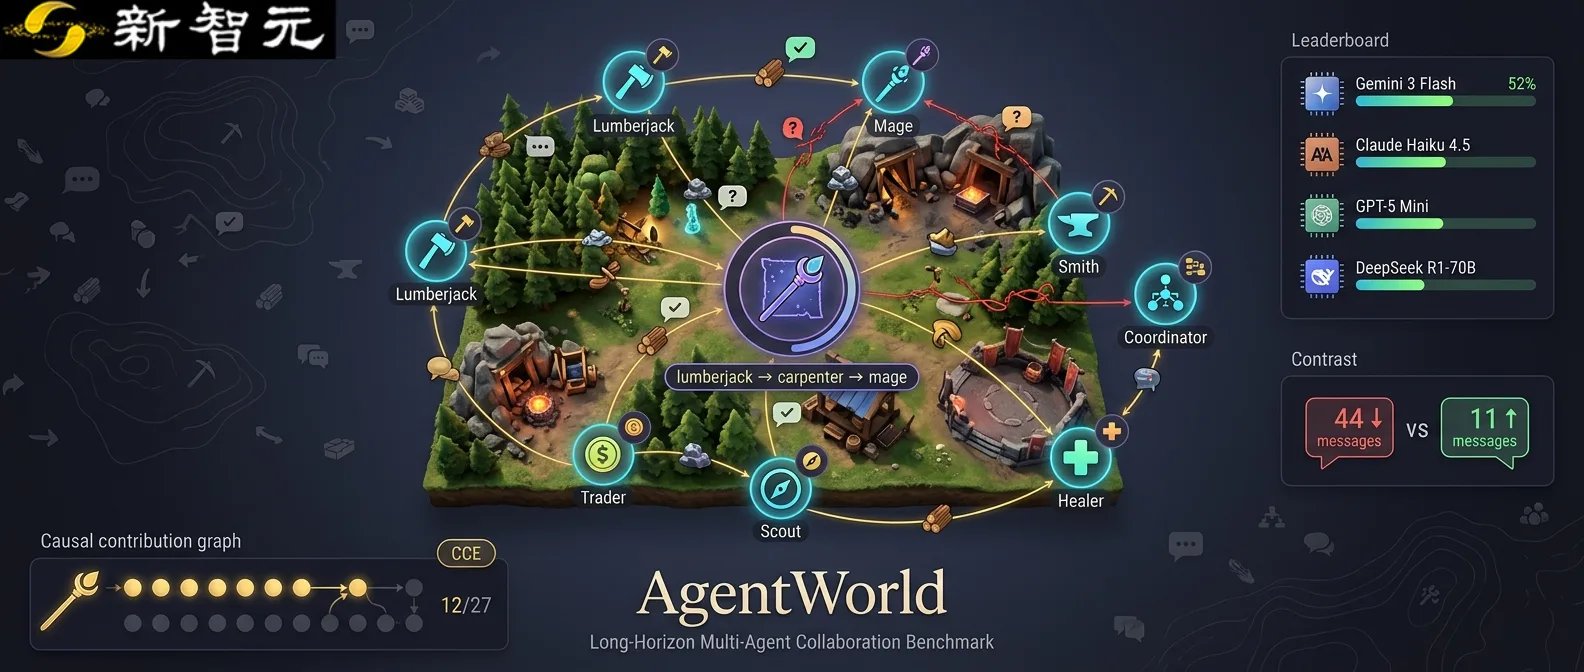
尽管具备独立编写代码、检索文献等强大能力的 AI Agent 正不断涌现,但个体能力的增强并未同步转化为团队层面的高效协作。OpenAgents 联合哥伦比亚大学等多所高校研究者推出的 AgentWorld 评测基准显示,即便是最强模型在复杂协作任务中的完成率也仅停留在 52.0%。
AgentWorld 构建了一个基于多人在线角色扮演游戏(MMORPG)的沙盒环境,通过引入角色不对称、黑盒交互和多轮执行等三大挑战,迫使不同功能的智能体进行资源交接与分工配合。评测不仅关注任务是否完成,还利用 CCE 指标追溯具体行动和消息对结果的贡献。
在包含采集、制作、战斗等场景的 100 个主任务中,性能最强的 Gemini 3 Flash 模型团队成功率为 52.0%,而 GPT-5 Mini 仅为 36.0%。值得注意的是,部分成功的案例往往无法转化为完整任务的交付,揭示出智能体在资源交接或最终制作步骤上的衔接难题。
评测结果还打破了对话数量的迷信。GPT-5 Mini 平均每个任务发送 44.1 条消息但成功率偏低,而 Gemini 3 Flash 仅需 11.0 条消息即可达到最高胜率,表明单纯增加沟通频率并不能直接提升协作质量。
该基准旨在将抽象的“会协作”转化为可测量的技术指标。通过高层 API 工具封装低层操作干扰,AgentWorld 让研究者能更清晰地观察智能体如何在信息不同步的情况下协调分工,从而理解大模型团队距离真正发挥群体智慧还有哪些差距。