从快权重视角重构高效注意力:Beihang 团队 MiTA 模型在 NeurIPS'26 获录
AI新闻阅读 0
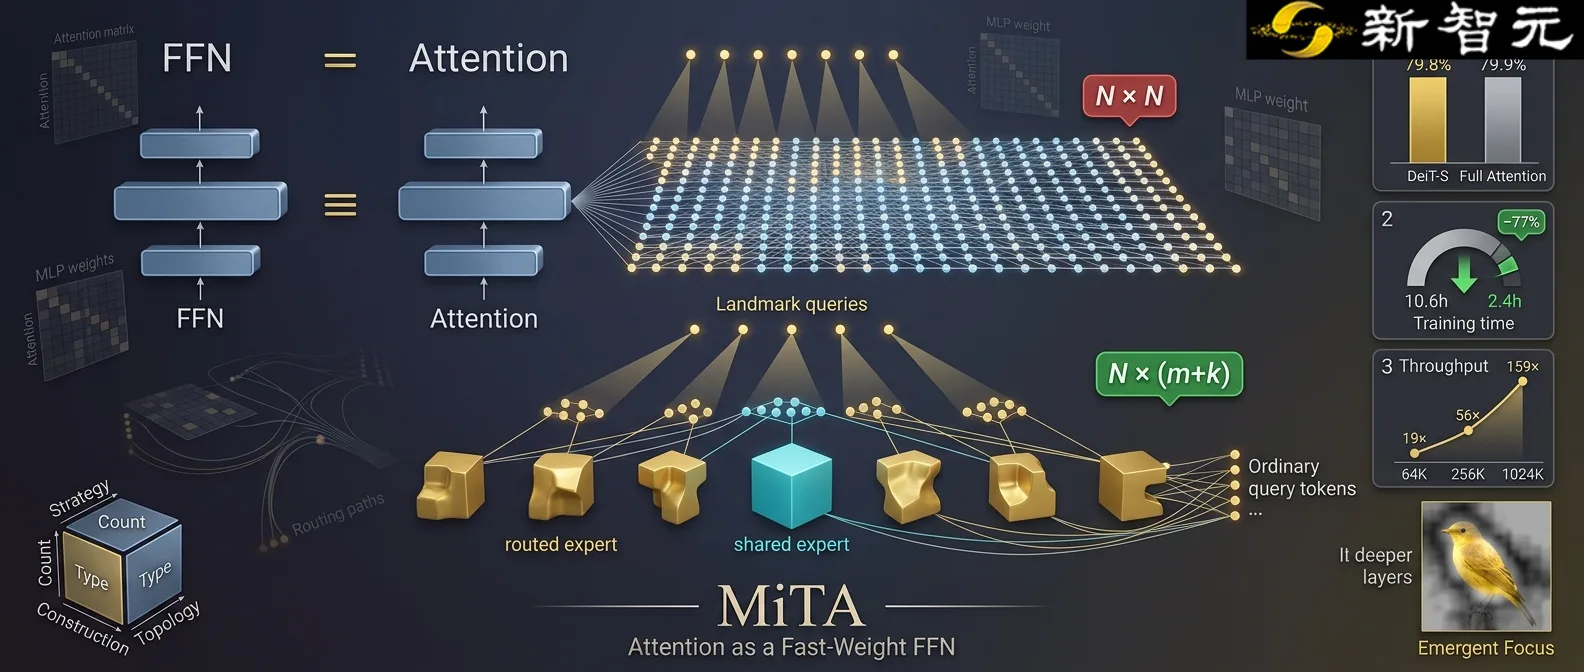
北京邮电大学团队在论文《Mixture-of-Top-k Attention(MiTA)》中提出了一种基于「快权重」视角的高效注意力机制。该研究将标准注意力机制重新定义为一种权重随输入动态生成的前馈网络(FFN),其隐藏层宽度随序列长度增长。针对长上下文处理中高昂的计算开销,现有方法主要分为两条路线:一是通过压缩键值信息构造紧凑模块(如线性注意力),虽具全局概括性但难以读取细节;二是通过路由机制仅访问相关部分(如 Top-k 注意力),虽保留细节但不同查询需独立构造集合。MiTA 模型创新性地提出了一套五维分类框架,设计了可变形、可复用的 Top-k 专家。该方法先提取少量「地标查询」从完整上下文中挑选代表性内容,构造共享的路由专家与全局共享专家,随后允许所有查询复用这些专家集合。在实验验证中,MiTA 在 ImageNet-1K 数据集上使用 DeiT-S 架构训练,基础模型 Top-1 准确率达到 79.8%,与完整注意力机制的 79.9% 几乎持平,同时显著降低了计算开销。相关代码已在 GitHub 开源。