小团队也能预训练!清华大学开源 Puro-2B:RTX 5090 集群训练成本低于 5090 美元
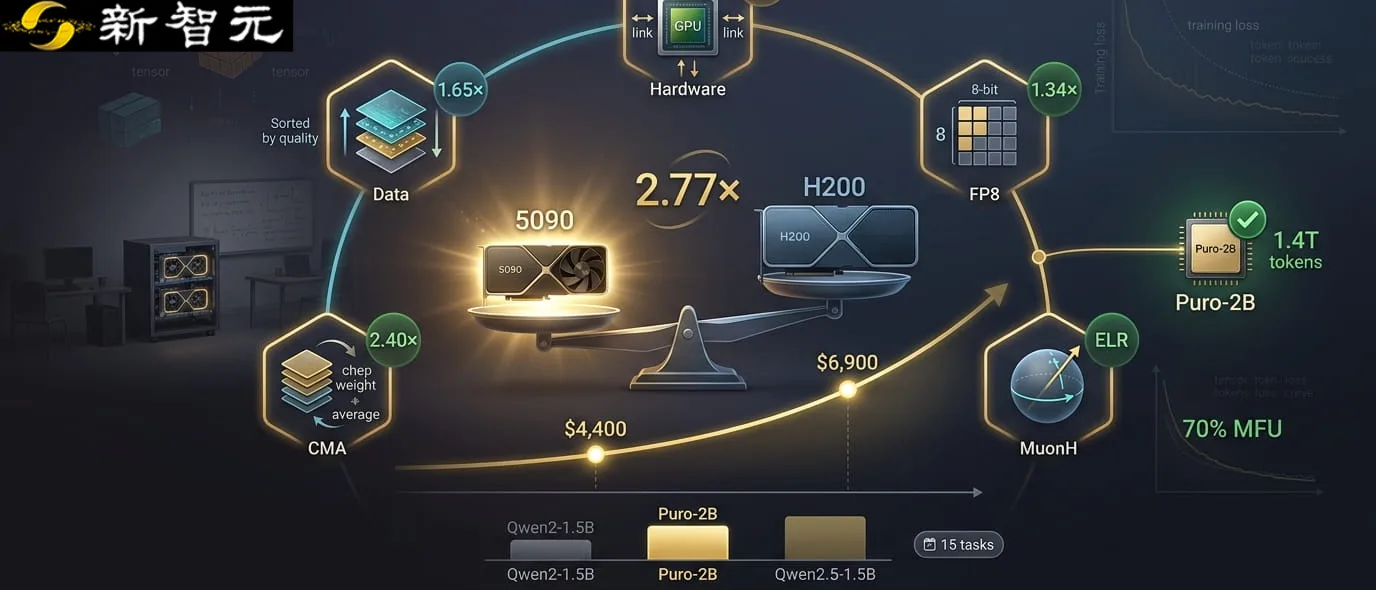
针对十亿参数级大模型预训练门槛高昂的难题,清华大学陈文光教授与吕凯风教授团队推出了全流程开源方案 Puro-2B。该方案在消费级 RTX 5090 显卡集群上,以约 4400 美元的算力成本从头训练了约 20 亿参数的模型,并在覆盖 15 项任务的评测中平均指标超越 Qwen2-1.5B。
与需要数十万美元成本的 OLMoE 及 SmolLM 复现方案相比,Puro-2B 显著降低了训练门槛。其核心在于针对消费级硬件进行了系统级的工程适配,解决了显存限制和通信带宽瓶颈问题,实现了单位成本下更高的算力利用率。
在硬件选型上,研究团队发现 RTX 5090 的 BF16 峰值算力/美元约为 H200 的 2.77 倍。尽管该卡仅有 32GB 显存且缺乏 NVLink,团队通过启用 PCIe P2P 通信和 GPU Direct RDMA 等技术,将节点内带宽提升至 56GB/s,延迟降低至 0.4µs,综合 MFU(浮点操作利用率)超过 70%。
在精度优化方面,Puro-2B 利用 RTX 5090 的 Blackwell 架构优势,采用 FP8 低精度格式训练线性层矩阵乘法。实验显示,相比 BF16,FP8 在验证损失仅微增约 0.003 的同时,将训练吞吐效率提升了 1.36 倍,折算后仍保持约 1.34 倍的净效率收益。
算法层面,团队采用 MuonH 优化器并设计了有效学习率(ELR)调度策略。通过权重投影和控制更新范数,ELR 的预设值不再随训练过程漂移。消融实验表明,合理的 ELR 调度比单纯选择优化器更能决定收敛效果,特别是在训练后期能维持更平缓的损失下降曲线。
为帮助研究者预估不同预算下的模型水平,团队发布了 Puro Cost Scaling Law 经验曲线。该曲线基于从同一检查点出发的第二阶段数据配比调整,允许研究者在正式训练前根据预算估算模型能力,避免了盲目复现最长训练过程的风险。