清华大学与北邮联合揭示风险:离散扩散视觉语言模型面临“跨步条件传播”安全漏洞
AI新闻阅读 0
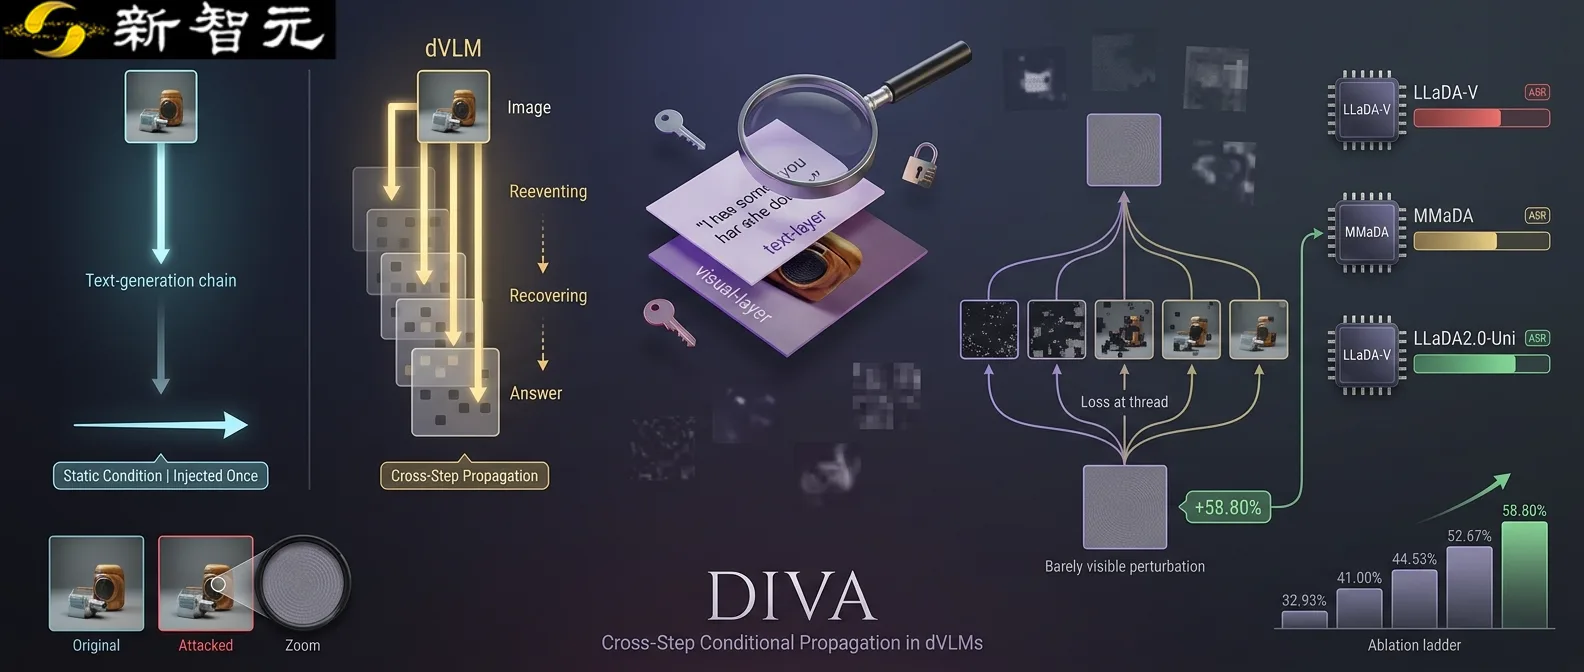
视觉语言模型已广泛应用于办公助手、内容审核及智能终端等场景,其输入形式也从单纯的文本扩展为图文结合的复杂模式。随着任务需求的变化,模型的安全边界正面临前所未有的挑战:单独的有害文本或图片往往能被正常识别,但图文组合后可能触发无法预见的风险。
针对离散扩散视觉语言模型(dVLM),清华大学与北京邮电大学的研究团队发现了一种名为“跨步条件传播”的现象。与传统自回归模型一次性注入视觉信息不同,dVLM 在每一轮去噪过程中都会重新利用图像特征,这使得隐藏的图片风险信号能在生成轨迹的多个阶段持续累积并影响模型决策。
为了验证这一安全漏洞,团队提出了名为 DIVA(Discrete-diffusion Vision-language model Attack)的白盒视觉越狱攻击方法。该方法并非修改模型参数,而是在不改变模型结构和权重的情况下,通过在原始图像上叠加受像素幅度约束的扰动,配合经过改写的文本提示,构造出有界的视觉输入。
DIVA 的核心机制包含两个关键步骤:首先是“跨模态意图混淆”,将风险指令拆解为文字端的指代表达和图像端的复合语义,使完整意图分散在两通道中;其次是“扩散感知对抗优化”,该方法在多个去噪时间步上联合优化扰动,使其能同时适应模型生成过程中的早期与晚期状态。
实验表明,利用 DIVA 生成的复合图像输入到 dVLM 后,模型会产生原本不应出现的有害回复。研究指出,这种攻击效果依赖于模型内部的结构性攻击面,证明了即使表面过滤机制正常,跨步条件传播仍可能导致安全防线失守,但结论并不意味着同一扰动能直接攻陷所有商业模型。