Google Gemini 4 Argon 在 ARC-AGI-3 考场获 97.5% 高分,领先标准操作环境成绩近 50%
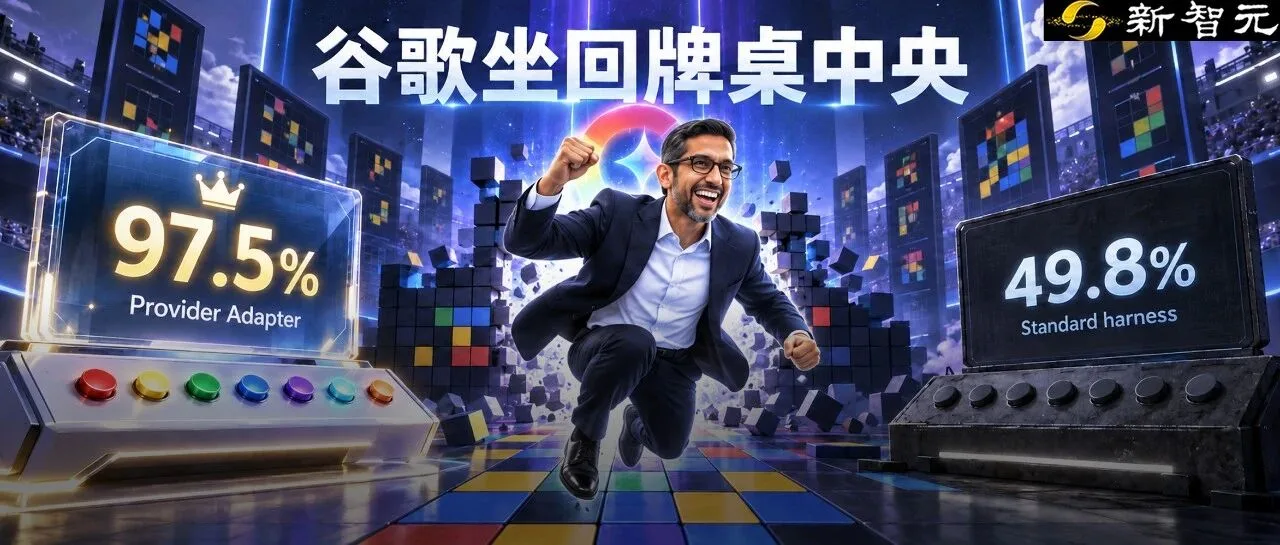
ARC Prize 官方近日公布成绩单显示,Google DeepMind 发布的模型 Gemini 4 Argon 在被称为“AGI 终极考场”的 ARC-AGI-3 基准测试中取得了 97.5% 的得分。
这一成绩使 Google 成为继 OpenAI 之后,第二家在 ARC-AGI-3 上突破 95% 门槛的人工智能实验室。相比之下,七个月前该考场开放时,所有前沿模型的得分均未达到 1%。
Gemini 4 Argon 在 25 个公开游戏中展现了极高的行动效率,其通关所需的行动次数比人类基线平均少了 62%,在三个游戏中追平了速通玩家纪录,另有六个游戏差距不足 10%。
然而,官方数据同时揭示了操作环境(harness)对分数的决定性影响。在专为模型定制的 Provider Adapter 环境下,Gemini 4 Argon 获得 97.5% 分数;而在统一发布的 Standard harness 环境下,同一模型的得分仅为 49.8%,相差近 48 个百分点。
效率数据的异常波动也佐证了环境的影响:在标准环境下,投入更多推理成本并未带来分数提升,高推理档位因 API 问题甚至未能完成足够数量的游戏。OpenAI 的 GPT-6 Astra 模型同样仅在定制化环境下达到 99.9% 的高分。
ARC Prize 联合创始人 Mike Knoop 指出,Gemini 4 Argon 是第二个有效最大化利用 ARC-AGI-3 复杂环境的模型家族。目前 ARC-AGI-3 的排行榜主要由 OpenAI 和 Google DeepMind 主导,其他厂商如 Anthropic 的 Claude 系列表现相对落后或暂无相关数据。
此次成绩表明,衡量大模型智能的尺度正从单纯的算法能力转向“模型 + 操作环境”的系统化能力,未来的 AI 评估需同时关注得分及其背后的技术配置。