港科广新基准发布:仅凭静态截图,AI能否推断并实现App交互逻辑?
AI新闻阅读 0
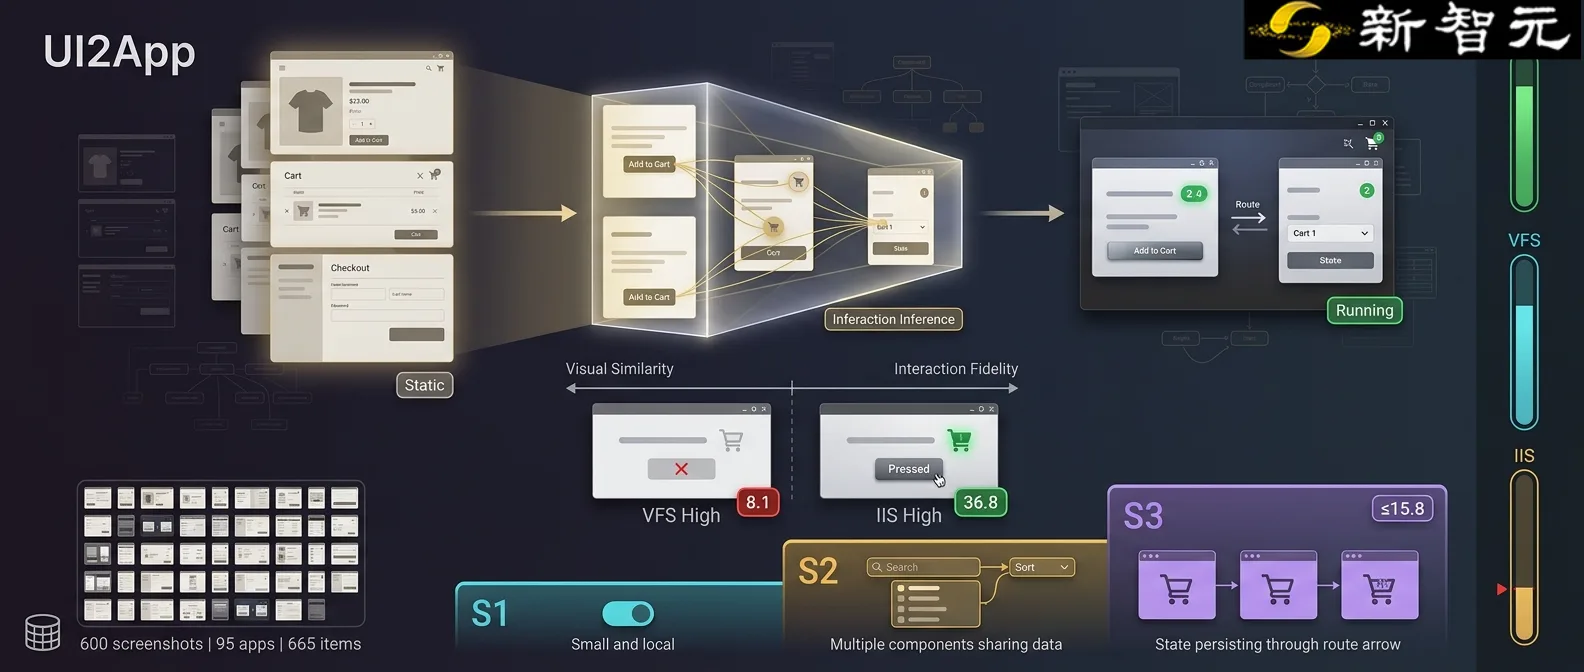
香港科技大学(广州)近日发布了一个名为UI2App的新基准评测体系,旨在测试大语言模型在缺乏功能说明和操作轨迹的情况下,仅通过静态网页截图便能推断隐含应用行为并实现可运行代码的能力。该研究将这种能力定义为'交互推断'(Interaction Inference),填补了现有评测主要关注视觉相似度而忽视应用逻辑的空白。UI2App包含600张截图,组成了95组状态一致的多页面Web应用,构建了665个涵盖从局部UI到跨页面状态的评测项。模型需在不获知点击轨迹或额外行为指导的前提下,生成可运行的React应用,并在执行过程中验证状态管理的正确性,确保交互不仅‘看起来像’还能产生预期结果。该基准依据状态作用范围将交互复杂度划分为三个层级:S1为局部UI状态(如按钮开关),S2涉及多组件共享数据(如搜索排序),S3则要求状态跨路由持续存在(如购物车、登录态)。研究显示,即便在视觉还原度最高的模型上,其交互推断得分也仅为8.1%,而目前表现最佳者IIS得分为36.8%,凸显了仅从静态画面理解应用逻辑的巨大挑战。评测结果揭示,视觉还原分数并不能代表模型对交互行为的实际实现能力。例如Gemini 3.1 Pro Preview在视觉相似度(VFS)得分73.2排名第一,但交互推断(IIS)仅得8.1分排名第四;而Claude Sonnet 4.6虽视觉得分略低(71.3),但在交互推断上以36.8分的最高成绩领先。特别是在最复杂的跨路由状态任务中,除头部模型外其余参评者得分均未超过3.5分。这项研究通过量化'从看懂界面到理解应用如何工作'的差距,推动Screenshot-to-App生成技术向更自主的方向发展。它明确指出,未来的模型评估不仅需要关注页面外观的复刻程度,更需重点考察其能否仅凭有限视觉线索推断出复杂的应用行为,并将其落实为真正可运行的交互逻辑,为相关领域的研发提供新的对比基础。