NeurIPS'26|大模型存在“思考惯性”:答案越开放,模型越难停止推理过程
AI新闻阅读 0
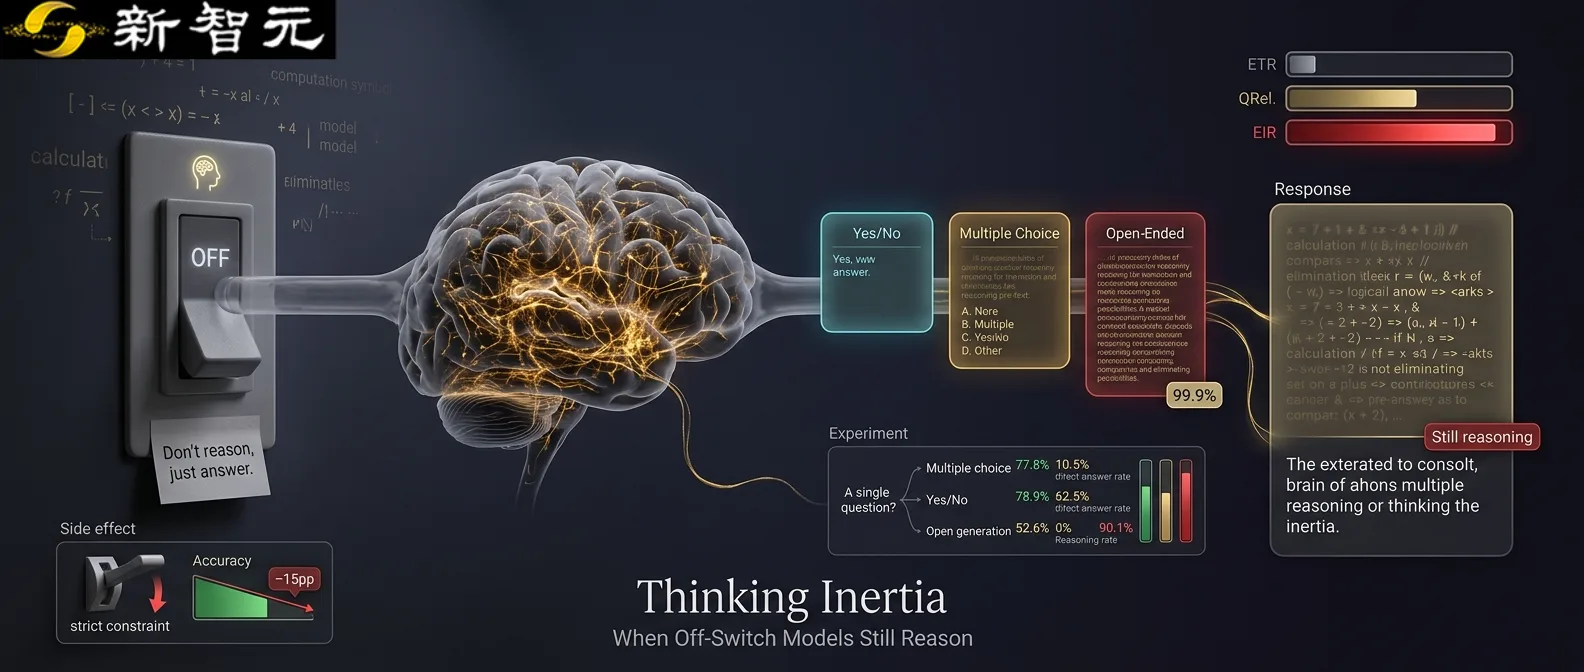
来自清华大学、牛津大学和斯坦福大学的研究团队在 NeurIPS 2026 发表论文,揭示了大型语言模型中一种被称为“思考惯性”(Thinking Inertia)的现象。研究通过实验证明,即使用户关闭模型的思考模式开关或明确指令其仅输出答案,模型仍可能在不被允许的区域内写入计算过程或推导步骤。研究人员发现,这种现象在开放性数学题中最为明显,而在判断是非题时则相对较少。即便严格限制模型只输出选项,其在 GPT 和 Gemini 等主流模型中的显式推理比例依然居高不下。这表明单纯关闭思考开关并不能自动保证模型遵循“只给答案”的指令。为了更精准地评估这一行为,研究团队将回答拆分为前置文字与最终答案,并设计了三层指标进行检查:ETR 确保答案格式合法且无实质性文字干扰;QRel 衡量前置文字与问题的相关性;EIR 则专门检测是否存在计算、比较或排除等显式推理步骤。在 600 条抽样数据中,人工标注与自动评判的一致性高达 98.8%。实验覆盖了 Qwen3、DeepSeek、GPT 和 Gemini 四个家族的六个模型。结果显示,当题目从有候选答案的选择题变为需要自行生成结果的开放题时,模型在输出答案前构造推理过程的比例显著上升。例如,DeepSeek-V4-Flash 在关闭思考模式后,针对 GSM8K 和 MATH 基准的总体显式推理率仍接近 99.9%。研究进一步指出,这种对推理过程的抑制与回答的准确性之间存在权衡。在对五个支持关闭思考模式的模型测试中,通过加入严格指令使开放题的“只给答案”比例从接近 0 提升到约 40%,但平均准确率因此下降了约 15 个百分点。论文第一作者、清华大学大四本科生 Dianqiao Lei 指出,能否按要求不输出推理并直接作答应成为独立评估模型能力的重要维度。该研究不仅发布了详细的轨迹数据和代码,还引发了社区对 Gemini-4-Argon 等模型的后续独立验证,证实了该现象的普遍性。这项工作的通讯作者包括牛津大学博士后 Kevin Qinghong Lin、Philip Torr 以及斯坦福大学教授 James Zou 等人。论文已被 NeurIPS 2026 接收,相关研究成果已在 arXiv 预印本平台公开,为理解大模型的内部机制提供了新的视角。