EMNLP'26|多模态大模型“读空气”失败,狼人杀基准测出社交盲区
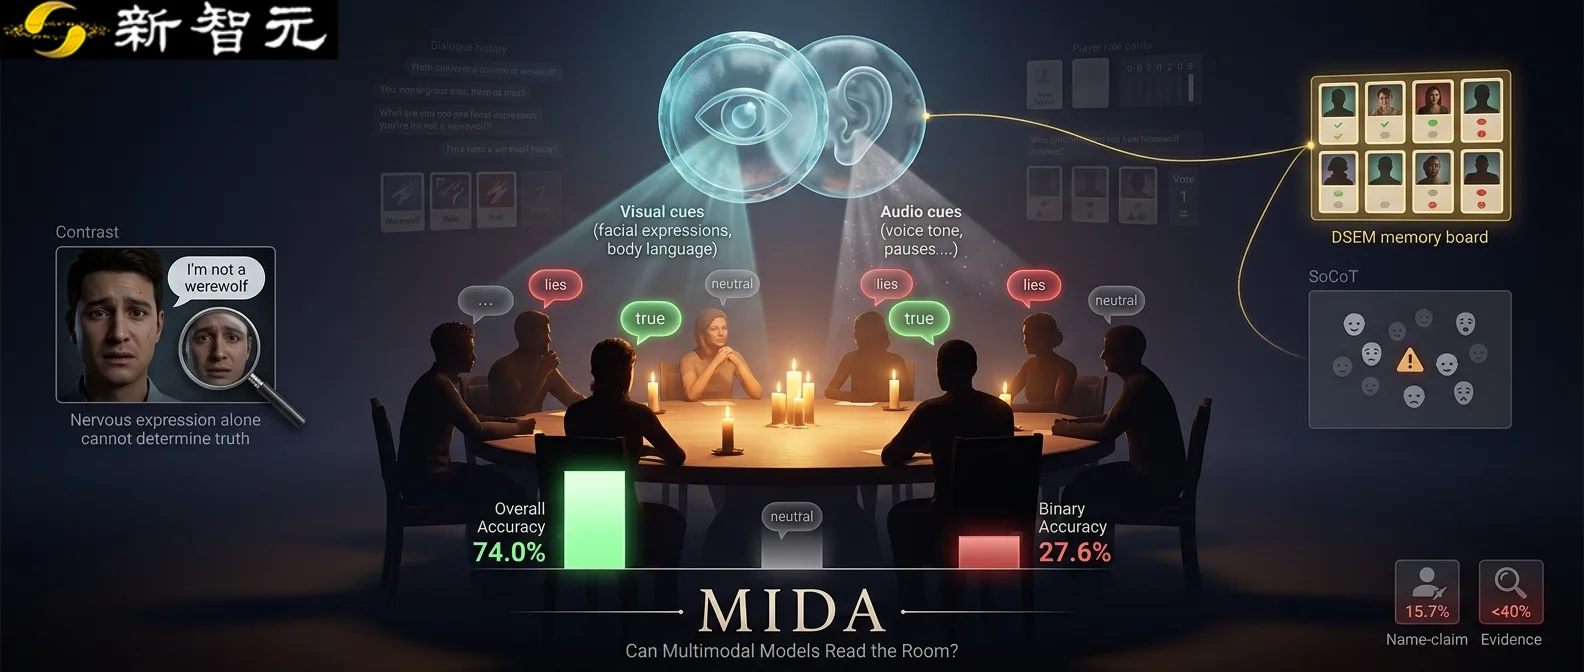
近日,东京大学研究团队发布了多模态交互式欺骗评估基准 MIDA,系统测试了 GPT、Gemini、Claude、Qwen、DeepSeek 等模型在多人社交互动中的欺骗判断能力。研究指出,尽管多模态大模型能理解图像、声音和文本,却难以准确捕捉说话者当时‘知道什么、相信什么’的社会心理状态。
MIDA 基准选取了‘一夜终极狼人’作为实验环境,涵盖 2360 条发言,其中 819 条来自 Ego4D 的线下游戏记录,1541 条源自 YouTube 视频。数据集构建流程包括人工记录夜间行动、结合规则与对话生成标签,并区分了新手(Ego4D)与资深玩家(YouTube)两种难度层级。
实验结果显示,模型的总体准确率存在误导性。在剔除大量‘中性’发言后,GPT-4o 的二分类准确率骤降至 27.6%,Qwen2.5-VL-7B 虽总体得分高但对‘假话’的识别 F1 值甚至为 0。模型往往通过频繁选择‘无法判断’来维持高分,而非真正识别谎言。
研究还发现,对需要社会推理的发言(如身份声明、证据指控),各模型表现最差,平均准确率不足 40%。此外,增加视觉帧数并未持续提升性能,移除对话历史会导致准确率大幅下降,证明语境记忆比面部微表情等视觉线索更为关键。
为提升判断能力,团队设计了社会思维链 SoCoT 和动态社会认知记忆 DSEM 两个模块。前者将非语言线索转化为结构化推理步骤,后者维护每位玩家的持续知识状态与关系变化,以避免模型因过度解读表面可疑特征而产生误判。
相关研究成果已被 EMNLP 2026 主会接收。论文链接为 https://arxiv.org/abs/2511.16221,项目主页位于 https://ut-vision-social.github.io/,代码与数据集分别开源在 GitHub 和 HuggingFace 平台。