AI 真实工程设计能力大考:多模型在 RWE-Bench 中表现惨淡,最高仅获 37%
AI新闻阅读 0
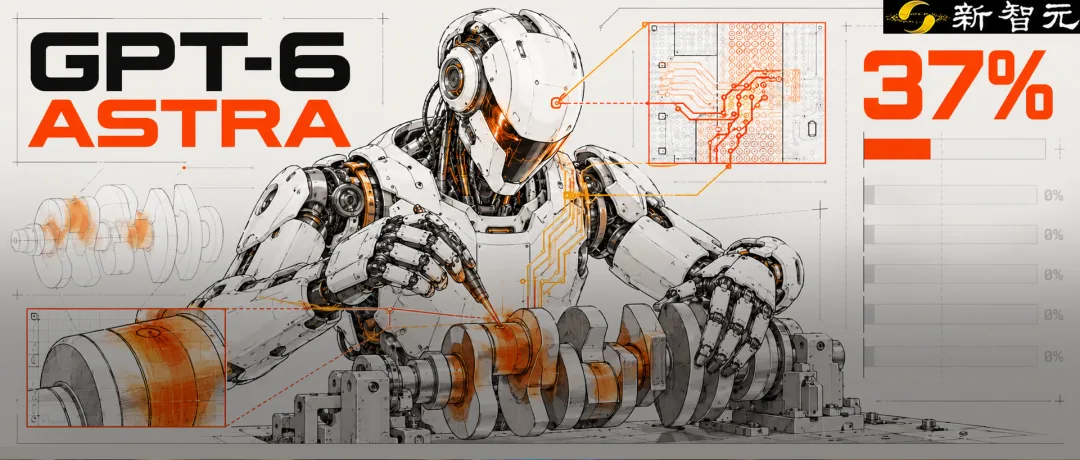
近日发布的现实世界工程基准测试(RWE-Bench)结果显示,主流大语言模型在实际工程设计任务中表现不佳。由 Xplore AI 于 10 月 27 日推出的评测体系包含机械、航空航天和电子三大类共 20 道专业题目,要求模型在 24 小时内完成从建模到仿真的全过程。
在该评测中,表现最佳的 GPT-6 Astra 通过率为 37%,其余主流模型成绩大幅下降。Claude Opus 5.5 得分为 29%,GPT-6.1 Sol 为 25%,Gemini 4 Argon 仅为 12%。除了这些知名模型,榜单中其他模型的通过率几乎为零。
RWE-Bench 的题目由行业工程师原创,判分标准客观且严格,完全依赖物理求解器自动验证,而非人工或 AI 评分。以机械题为例,参赛模型需设计三缸柴油机曲轴,同时满足质量、应力、疲劳系数及变形量等多项硬指标;电子题则要求在固定布局的 FPGA 板上完成 DDR3 走线与时序优化。
尽管各模型在单次测试中用时普遍较短(平均仅两三小时),但部分模型可能因误判而提前交卷。此外,算力成本与分数提升不成正比,例如单价最高的 Claude Fable 5.1 通过率仅为 7%,而性价比相对较低的 GPT-6.1 Sol 得分略高。
此次评测存在样本量较小等局限性,官方未公布四道全员挂零题目的具体详情。Xplore AI 表示未来将扩展测试范围至生物力学、土木工程和材料工程等领域,并计划对最新的 Gemini 4 Carbon 进行专项补测。