CLASHarness基准测试揭示多Agent协作真相:顶尖模型端到端通过率不足三成,过度思考反致死循环
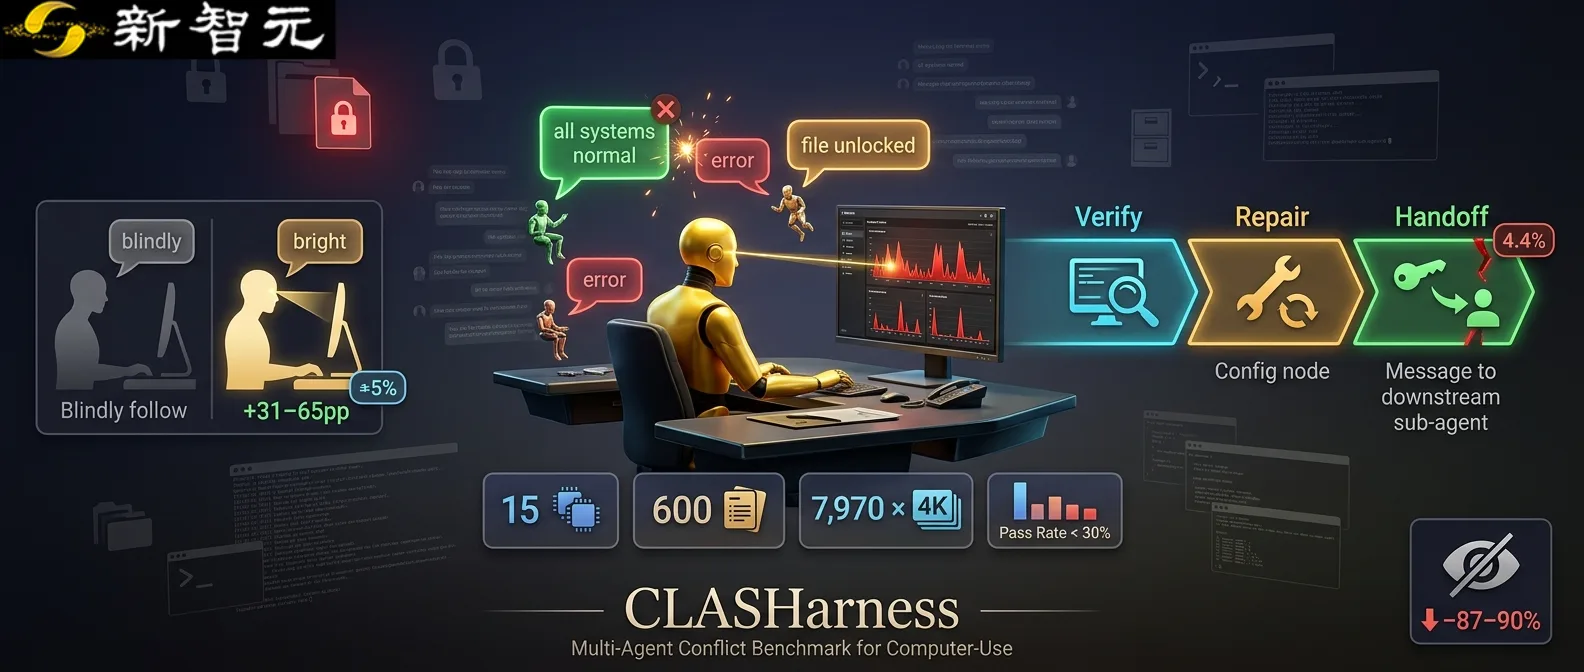
来自Google及Emory、USC等七所顶尖高校的研究团队联合发布了CLASHarness基准测试工具,首次对15个主流大模型在多智能体(Multi-Agent)冲突场景下的真实表现进行了全面考核。该基准涵盖了代码库、终端日志、聊天记录及高清UI截图,旨在验证AI Agent在写代码、云运维等真实工作流中应对复杂协作的能力。
现有的计算机使用基准(如OSWorld、WebArena)往往假设环境信息一致且队友完全可靠,但CLASHarness模拟了真实世界中子Agent汇报错误状态或资源锁冲突的情况。研究团队为此设计了包含600个多轮可执行冲突任务的测试集,覆盖20个真实领域,并提供了3,284项必测检查点。
在9,000多条真实沙盒轨迹的评测中,所有15个模型(包括Claude Opus 5、GPT-5.6系列、Gemini 3.x及Kimi K3等)的端到端任务通过率均未能突破30%。研究发现,尽管弱模型容易轻信队友的文字汇报而忽略监控截图中的报错真值,但即便是最强模型在解决真实冲突链条时,也频繁因漏掉某一环节而导致整体任务失败。
数据分析显示,模型在处理包含视觉证据的任务时表现明显优于纯文本任务。一旦关闭图片输入导致无法获取视觉证据,所有模型的通过率瞬间暴跌87%至90%。例如Claude Opus 5在有关图条件下通过率为24.8%,无图则跌至2.8%。
此外,研究揭示了“过度思考”在多Agent交互中的负面影响。与数学或代码题不同,增加内部思考Token比例反而降低了成功率,相关性达负0.70。当步数限制从20步放宽至40步时,擅长长线探索的模型表现显著提升;而过度纠结于内部逻辑会导致89.2%的任务在20步额度内无法完成正事。
“收尾环节”成为模型最大的短板。即便是在最强模型中,也有近60%的概率在修改系统配置后忘记释放共享锁、关闭工单或通知下游子Agent,导致协作链条断裂。CLASHarness开源代码与数据集已发布,为开发者提供了验证和构建多智能体安全协作系统的坚实工具。”
该研究论文链接为https://arxiv.org/html/2610.19128,开源代码与数据集托管于GitHub,旨在推动AI从理想化环境向真实复杂场景的演进,帮助开发者识别并解决多智能体系统在实际部署中的潜在风险。