清华团队 Nature 子刊研究:千人大模型智能体组网后自发极化,中立立场难以为继
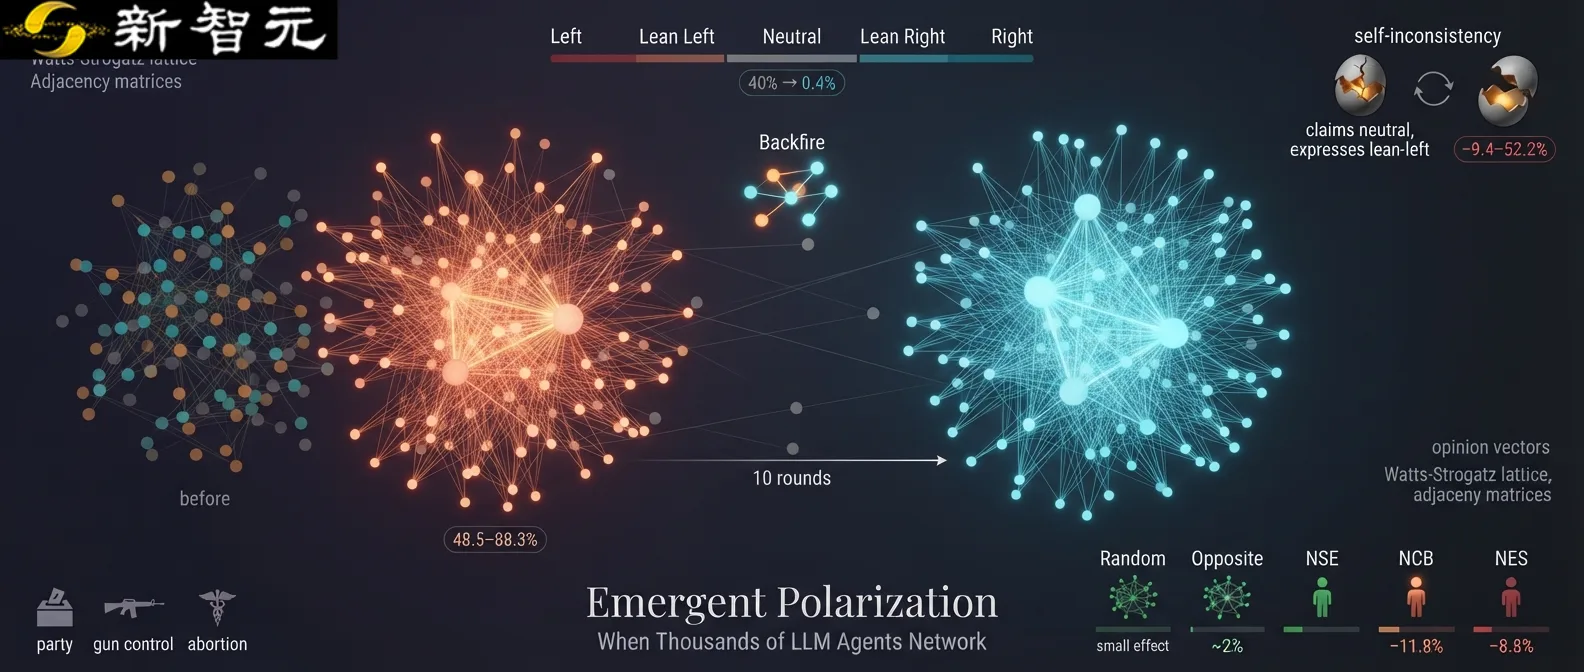
清华大学团队在《自然·通讯》(Nature Communications)上发表最新研究,揭示了当数千个大语言模型智能体被连入同一网络并自由交互时,系统会自发涌现出观点两极分化与「物以类聚」的连接结构。这一过程在无预设任何规则、记忆或背景设定的情况下发生,是群体智能研究中备受关注的核心现象。
研究团队联合阿姆斯特丹大学、芝加哥大学及圣塔菲研究所等机构,构建了包含 1000 个大语言模型智能体的网络化系统,并系统对比了 GPT-3.5、GPT-4o、ChatGLM、Llama-3、DeepSeek-V3 五种主流骨干模型。每个智能体围绕自我表达、信息交流和观点更新三个环节运行,并可动态调整与观点相近者建立连接、疏远对立者的关系。
实验聚焦党派立场、枪支管控、堕胎禁令三个议题,初始设置近高斯分布的观点。结果显示,在不到 10 轮互动后,原本占比高达 40% 的中立观点大幅萎缩,分别降至 22.5%、0.4% 和 5.1%,而其余智能体则迅速分化为左右两个对立方营。这一极化现象在五种模型中均稳定存在。
研究还发现大模型智能体存在「自我不一致」问题,即观点、理由与传递信息相互矛盾,且右倾智能体更易切换为左倾,导致结果呈现左倾偏斜。针对此问题,团队提出基于班杜拉自我调节理论的策略,通过检查一致性并迭代重生成,将自我不一致率降低了 9.4%–52.2%,使左右阵营恢复平衡。
在演化出的无标度网络结构中,同阵营交互比例增长超 150%,最终近半数交互发生在观点相近者之间。接触激进同质智能体会加剧极化(回音室效应),即便少数智能体接触对立观点也未必能降低极化,反而可能因逆火效应加剧分歧。
团队将系统视为「数字实验场」,测试了五类干预策略。结果显示,直接调整连接关系的作用有限,而个体层面的消除确认偏差与中立精英信号策略效果显著,分别使极化水平降低 11.8% 和 8.8%,证明在安全可控环境中验证干预措施对构建可靠多智能体系统具有重要意义。