实测显示:面对5000词需求文档,当前Agent仅能交付14%功能,大型软件系统演进仍是难题
AI新闻阅读 0
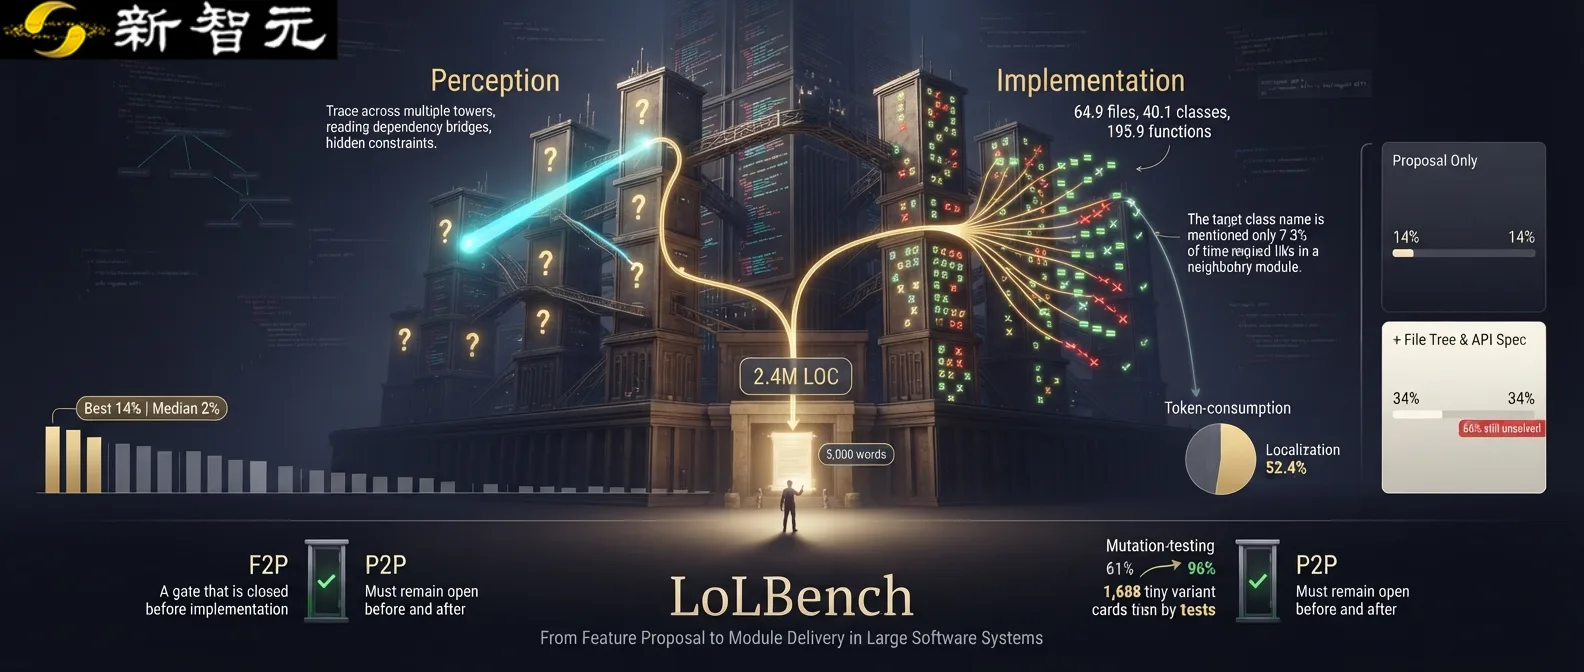
复旦大学、香港城市大学及香港中文大学等机构联合提出了LoLBench评测基准,旨在评估人工智能代理(Agent)在大型软件系统中的代码生成与交付能力。该基准将Agent置于平均约240万行源代码的复杂环境中,要求其从一份功能提案出发,独立完成跨模块修改并验证交付结果。实验结果显示,即使面对平均仅5000个英文单词的需求文档,现有最先进的Agent组合最高解决率也仅为14%。尽管研究团队尝试通过补充实现指引来辅助Agent,但仍有66%的任务未能完全解决,表明从需求理解到功能交付之间存在巨大鸿沟。与以往聚焦局部Bug修复的评测不同,LoLBench特别强调长程代码任务中的感知复杂性与实现复杂性。前者涉及识别跨模块依赖和隐含约束,后者则要求在不破坏现有架构的前提下完成多文件修改并通过回归测试。在28种不同的模型与脚手架组合实验中,Opus 5搭配Claude Code或mini-SWE-agent表现最佳,平均解决率为14%,而所有组合的中位数仅为2%。分析指出,Agent大量交互轮数和Token消耗主要耗费在代码定位阶段,但即便如此仍难以覆盖所有必要改动。LoLBench数据集覆盖了29个开源系统、8种编程语言和5个应用领域,选取了100项来自社区功能提案的任务进行评测。评测环境设定为断网状态以防止外部检索,真实模拟开发者在仅有提案和现有代码仓情况下的工作挑战。为了进一步验证交付质量,研究团队在原有测试基础上构建了包含遗漏功能和篡改需求的变异体,使错误检出率从约61%提升至96%。这一结果表明,当前技术虽能生成部分代码,但缺乏对复杂系统整体变更的可靠掌控能力。研究成果发布在arXiv平台,相关数据集已在HuggingFace公开。研究团队希望推动Agent评估标准从单纯关注代码生成转向支持软件的持续演进,让实际交付结果成为检验智能代理能力的核心尺度。