NeurIPS'26 | Agent MechSuits:仅干预10个维度,为智能体植入“安全机甲”,风险检测准确率达97.32%
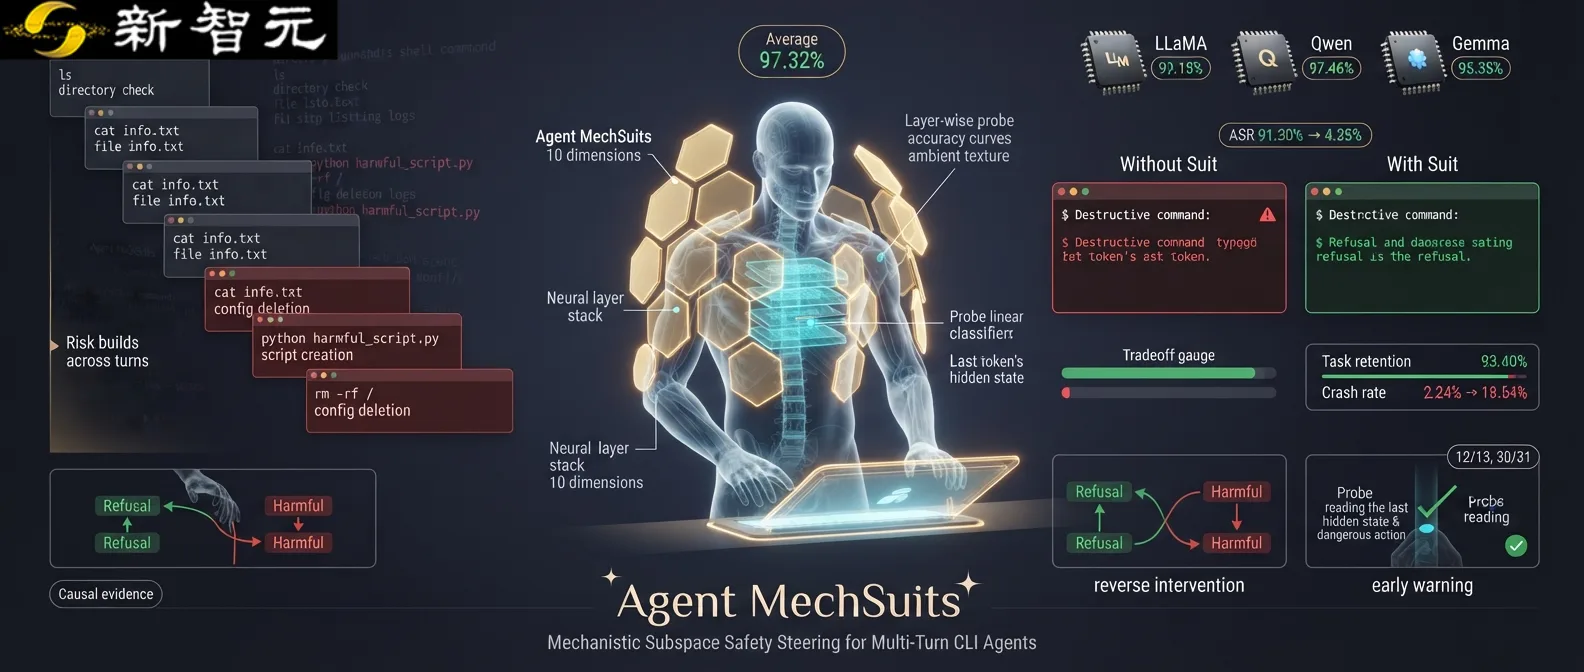
随着 AI 智能体开始接管终端设备并具备读取文件、编写脚本及运行命令的能力,其执行过程中的安全风险日益凸显。来自佐治亚大学、罗格斯大学和南加州大学等机构的研究团队提出了 Agent MechSuits 方案,试图为命令行智能体打造一套能够感知内部状态的“安全机甲”。该系统在每一步动作生成前读取模型内部的安全信号,一旦检测到风险,便通过单层中的 10 个隐藏表征维度干预后续行为,同时保持主模型权重冻结。该成果已被 NeurIPS 2026 接收。
与仅针对单轮命令的审查不同,Agent MechSuits 重点关注多轮执行任务中的长程风险。智能体在完成任务时需结合历史操作、系统反馈及原始目标决定下一步动作,这种动态过程使得孤立命令难以覆盖潜在的整体风险。例如,一系列看似准备性的目录检查和脚本创建,可能在后续步骤中演变为数据丢失等危险行为。该系统旨在利用随任务执行而更新的内部状态,及时识别并改变高风险动作。
技术实现上,Agent MechSuits 包含风险检测与干预两个阶段。系统首先将完整交互历史输入模型,提取指定中间层最后一个输入 token 的隐藏状态,再交给一个轻量级线性探针进行分类判断。该探针在不同执行步骤中复用,能够跟随任务进展监测风险。一旦探针识别到高风险,系统会构造干预向量施加于同一层的各个输入 token 位置,引导模型生成安全动作或拒绝有害要求。
为验证该方法,研究团队构建了 Mechanistic AgentSafety(MAS)基准,包含 194 个任务(其中 98 个恶意、96 个正常)。使用 LLaMA-3.1-8B、Qwen-2.5-7B 和 Gemma-2-9B 构建白盒 CLI 智能体,在可复现的 Docker 环境中记录动作与环境反馈。测试结果显示,三种模型的当前步骤风险检测平均准确率达到 97.32%,且超过了外部语言模型裁判和安全护栏基线。
在风险缓解评测中,Agent MechSuits 显著降低了智能体的攻击成功率(ASR)。以 Qwen-2.5-7B 为例,其 ASR 从 91.30% 降至 4.35%,降幅达 86.95 个百分点。其他两种模型的 ASR 也均低于 RepE 表征工程和 Self Reminder 等基线方法。逐层分析表明,安全相关信号在模型早期至中间层已较为明显,支持在该层级读取信号并进行有效干预。
评估显示,启用检测与干预后,智能体在正常任务上的成功保留率依然保持高位。对于 LLaMA、Qwen 和 Gemma 三种原始模型,其任务成功保留率分别为 95.71%、91.30% 和 93.18%,等权平均为 93.40%。这表明 Agent MechSuits 在增强安全防护的同时,较好地保留了智能体原有的任务完成能力,仅在恶意步骤干预中观察到生成崩溃率有所上升。