清华开源 OpenMise:给视频生成模型装上「三维空间大脑」,告别反复抽卡难题
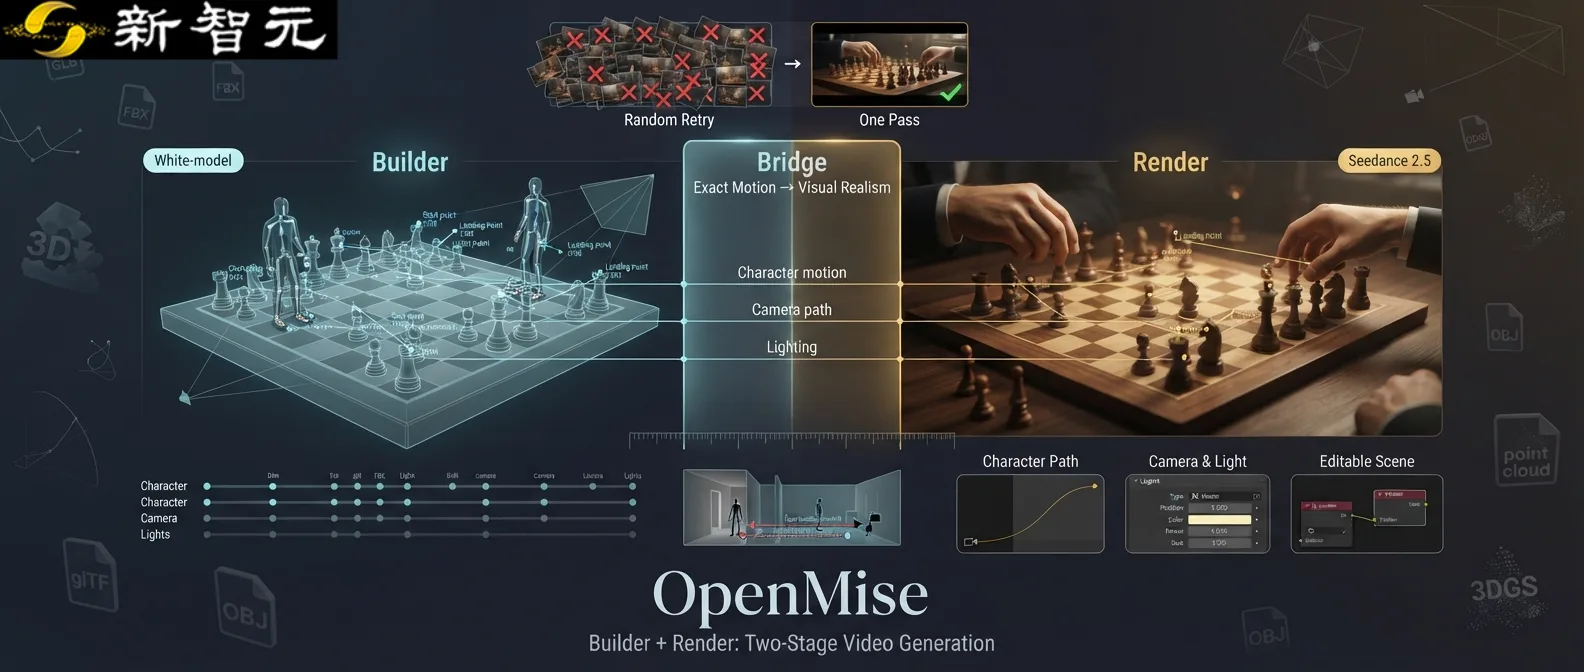
当前主流的视频生成大模型,例如 Seedance 2.5,在处理复杂用户意图时仍存在明显的细节一致性问题。以生成两名角色下国际象棋的写实视频为例,虽然模型能准确识别人物和基础动作,但在连续镜头中棋子位置会逐渐混乱,出现上一帧棋子在格、下一帧移位甚至凭空消失的现象,导致棋局逻辑崩坏。
这种现象常被创作者称为“抽卡”体验:用户虽对路径和镜头做了明确规划,但生成结果仍可能出现穿墙或跑偏。对于涉及精确动作和内容连贯性的创作,用户要求已从单纯追求画质升级为确保内容按计划发生且前后一致。现有模型难以同时兼顾精确的细节把控与高质量渲染。
为此,来自清华大学和宾夕法尼亚大学的团队开源了名为 OpenMise 的空间场景编辑工具。该项目定位为连接 Agent 与空间场景的桥梁,其核心思路是将困难的视频生成任务拆解为两个简单阶段:首先利用 Agent 调用 Blender 等工具,在三维世界中安排场景、人物、动作及光影以生成可修改的草稿;随后再将草稿交给现有视频生成模型完成写实渲染。
OpenMise 的技术架构分为 Builder(建造者)和 Render(渲染器)两部分。Builder 阶段由 Coding Agent(如 Deepseek V4.1 Flash)主导,负责将自然语言剧本拆分为可执行的三维制作计划,通过调用工具导入资产、计算路径、创建骨骼动作及配置灯光,输出符合物理规律的白模草稿。Render 阶段则由 Seedance 2.5 等模型负责,只需专注于将准确的白模状态渲染为清晰真实的画面,无需维护复杂的连续逻辑。
相比直接生成或反复试错,OpenMise 的两阶段流程显著提升了视频一致性。在使用国际象棋的例子中,系统先在 Blender 中构建精确的棋子移动序列和白模视频供创作者检查,再基于此生成最终作品。这种方法让创作者能够定位并修改具体环节,如调整路径、修正穿墙镜头或优化光照,而非整段重新生成。
在 Builder 阶段,团队还针对三维资产理解提出了创新方案。系统支持原生 Blender 场景及 3DGS 扫描等多种格式,但需经过坐标校准、尺度校准与空间标注,将“看得见”的房间转化为可规划路径和机位的空间表示。未来 OpenMise 还将处理人物运动中整体位移与骨骼动作的分开生成,以适应更多复杂的人物视频创作需求。”,