南京大学新基准揭示AI写测真相:测试合格率被高估一倍
AI新闻阅读 0
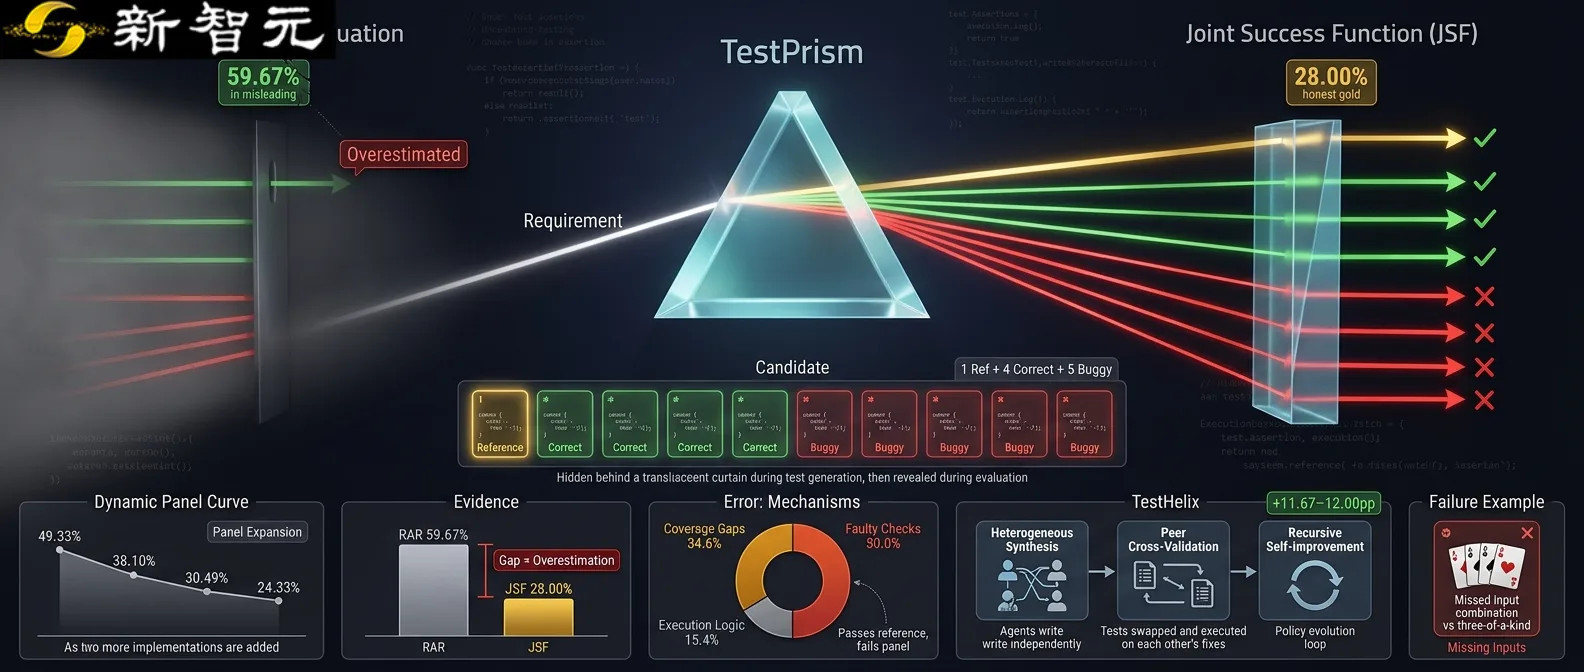
南京大学刘佳恒老师团队近日提出了一种新的代码测试生成基准 TestPrism,旨在重新评估当前 AI Coding Agent 的测试编写能力。研究指出,由于现有评测主要依赖单一参考答案,导致生成的测试质量被严重高估,实际合格率可能仅为表面数据的一半。该团队构建的 TestPrism 基准包含来自 17 个来源的 300 个测试任务和 3000 个候选实现。每个任务均配备经过专家验证的正确与错误实现面板,并以联合成功函数(JSF)为核心指标,要求测试必须能拒绝所有错误实现且接受所有正确实现。数据显示,在现有的单一参考评测标准下,最强配置的 AI Agent 测试通过率达 59.67%;但在 TestPrism 的严格标准下,其 JSF 得分仅为 28.00%。研究进一步通过对失败轨迹进行专家标注,归纳出三类七大类测试生成错误机制。针对这些问题,团队提出了 TestHelix 框架,利用异构合成、同伴交叉验证与递归自我改进技术。在相同的推理预算下,该框架将 JSF 评分提升了约 12 个百分点,显著改善了测试生成的鲁棒性。现有评测普遍采用“修复前失败、修复后通过”的标准,隐含假设测试能区分任意正确实现与错误实现。然而现实中,测试可能遗漏关键输入或过度依赖参考答案的具体写法,导致对缺陷代码放行或对正确变体误判。TestPrism 为此为每个任务配备包含 1 份参考、4 份正确替代及 5 份错误实现的候选面板,并制定了严格的多样性过滤标准。该基准覆盖 Python、JavaScript、Java、C/C++ 和 Go 等六种语言,涉及仓库维护、函数演化等多种场景。研究论文已发布在 arXiv 预印本平台,相关数据与代码开源于 GitHub。这一工作为未来构建更可靠的 AI 代码评测体系提供了新的方法论和数据支撑。